

Îi ceri unui asistent AI să îți explice un contract, să rezume un document medical sau să găsească informații într-o căsuță de e-mail. Răspunsul poate fi rapid și util. Dar înainte să încarci fișierul sau să conectezi aplicația, apare o întrebare pe care este ușor să o treci cu vederea: ce informații îi oferi sistemului și ce poate face cu ele?

Folosirea în siguranță a inteligenței artificiale nu înseamnă să evităm tehnologia și nici să avem încredere oarbă într-un nume cunoscut. Înseamnă să înțelegem ce date sunt necesare, cine le prelucrează, ce permisiuni acordăm și unde păstrăm controlul. Aceste decizii fac diferența dintre o utilizare comodă și una responsabilă.
În articolul anterior din seria „AI-ul pe înțelesul tău”, am discutat despre fiabilitatea răspunsurilor: de ce un model poate greși, chiar și atunci când oferă o explicație convingătoare, și cum adaptăm verificarea la importanța unei activități.
Acum privim o altă latură a încrederii. Un răspuns poate fi corect, dar obținerea lui poate presupune transmiterea unor informații personale sau confidențiale.
De asemenea, un asistent care poate lucra cu alte aplicații poate primi drepturi mai extinse decât cele necesare.
Corectitudinea rezultatului și siguranța utilizării sunt două probleme diferite. Trebuie să le înțelegem pe amândouă.
Poți organiza explicațiile următoare în jurul a patru întrebări: ce informații trimit, ce serviciu le primește, ce acces îi ofer și ce trebuie să verific înainte? Distincțiile despre date, memorie și permisiuni te ajută să răspunzi concret la aceste întrebări.
1. Ce informații primește, de fapt, un asistent AI?
Când deschidem o conversație, pare că oferim sistemului doar întrebarea pe care o scriem. În practică, informațiile disponibile pot proveni din mai multe locuri.
Mesajele din conversație. Un text aparent obișnuit poate conține nume, salarii, probleme personale, date despre sănătate sau informații despre alte persoane. Nu este nevoie să atașăm un fișier pentru a transmite date sensibile.
Documentele și fotografiile. Un contract poate include CNP-uri, adrese, semnături sau conturi bancare. O fotografie poate surprinde persoane, documente ori detalii care permit identificarea unui loc. În funcție de format și de serviciu, fișierele pot avea și metadate.
Înregistrările audio și video. O cerere de transcriere poate implica transmiterea vocilor, conversațiilor sau imaginilor unor persoane. Scopul prelucrării nu elimină caracterul personal ori confidențial al conținutului.
Istoricul, memoria și contextul. Unele produse pot folosi, în condițiile setărilor și funcțiilor disponibile, informații din conversații anterioare sau preferințe păstrate pentru personalizare.
Aplicațiile conectate. Dacă autorizăm accesul la e-mail, calendar sau documente din cloud, sistemul poate primi informații fără ca noi să le introducem manual, în limitele funcțiilor și permisiunilor efectiv acordate.
Să presupunem că întrebi: „Cum îmi pot organiza mai eficient bugetul?”. Asistentul poate oferi o explicație generală fără să cunoască nimic despre situația ta financiară. Dacă îi încarci extrase bancare și facturi, cererea devine mult mai personală. Răspunsul poate fi mai adaptat, dar volumul informațiilor partajate crește considerabil.
De aceea, pe lângă „Ce vreau să facă AI-ul?”, trebuie să ne întrebăm și „De ce informații are nevoie pentru a face acel lucru?”
2. Ce informații necesită o atenție deosebită?
În Uniunea Europeană, Regulamentul general privind protecția datelor (GDPR) stabilește reguli pentru prelucrarea datelor personale. Acestea sunt informații referitoare la o persoană identificată sau identificabilă. Nu înseamnă doar nume și prenume: uneori, combinarea mai multor detalii poate permite identificarea cuiva.
Datele despre sănătate, de exemplu, beneficiază de un regim special de protecție. Alte informații, precum parolele și codurile de autentificare, ridică în primul rând probleme directe de securitate. Iar documentele profesionale pot fi confidențiale chiar dacă nu conțin date personale.
Pentru un utilizator obișnuit, următoarea hartă este mai utilă decât memorarea tuturor categoriilor juridice.
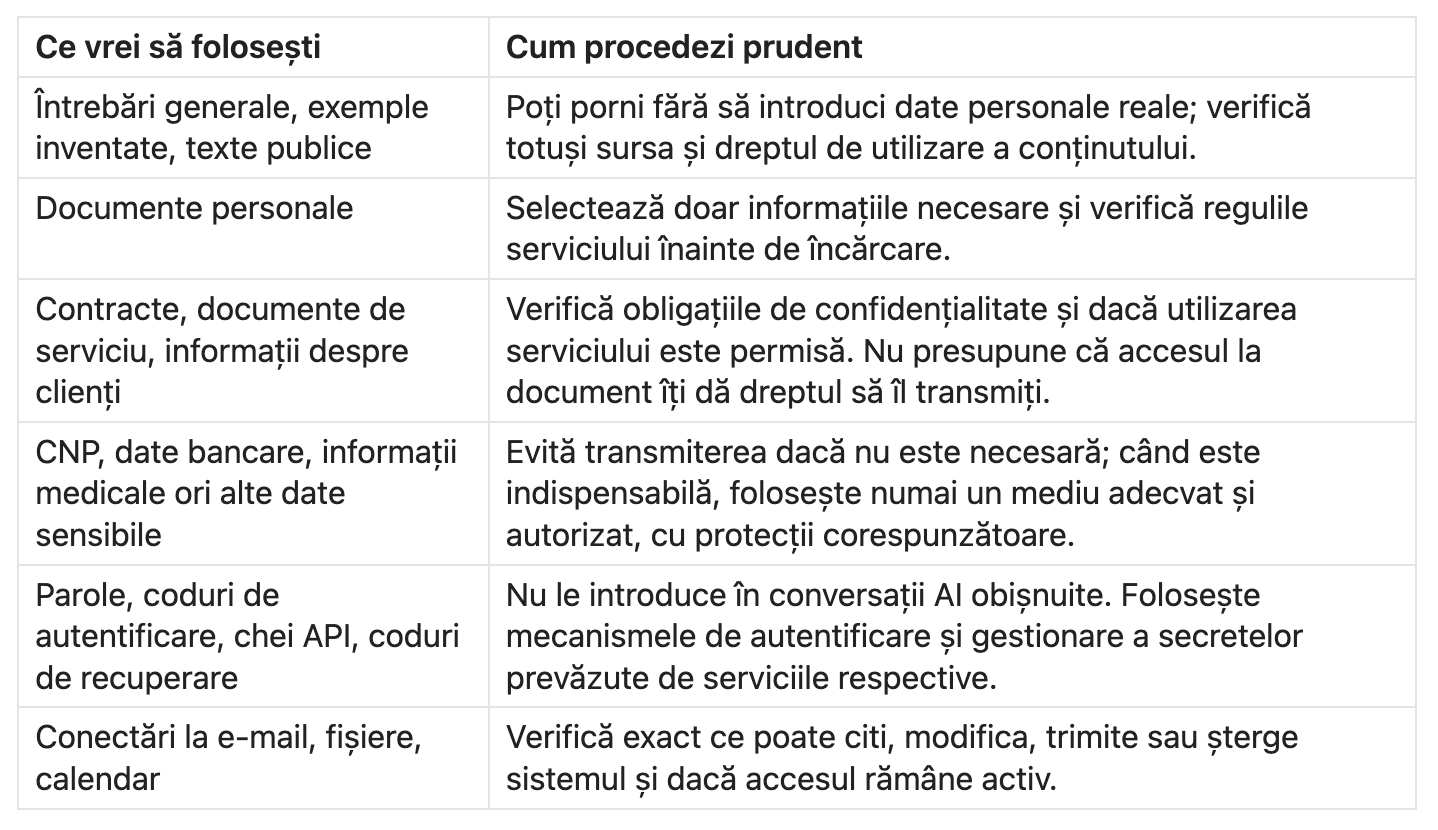
Tabelul nu înseamnă că o categorie este automat sigură, iar alta este întotdeauna interzisă. Riscul depinde de conținut, de serviciul folosit, de scop și de obligațiile aplicabile.
Principiul de bază: faptul că o informație poate îmbunătăți răspunsul nu înseamnă că trebuie transmisă integral.
Datele altor persoane nu devin automat ale noastre
Imaginează-ți că ai primit un contract de la un client sau o conversație privată de la un coleg. Poți avea acces legitim la acel material fără să ai automat și dreptul de a-l încărca într-o aplicație externă.
Aceeași precauție este necesară pentru fotografiile altor persoane, documentele de la angajator ori corespondența profesională. Trebuie să ținem cont de scopul pentru care informația ne-a fost încredințată, de regulile aplicabile și de eventualele obligații contractuale.
Pentru activități profesionale, o verificare internă poate fi necesară înainte de folosirea unui serviciu AI, chiar dacă documentul nu conține nume sau CNP-uri.
3. Unde ajung datele și ce înseamnă „conversație privată”?
Multe servicii AI funcționează prin infrastructură cloud. În acest caz, informațiile necesare sunt transmise către sistemele utilizate pentru procesarea cererii. Dar prelucrarea, stocarea, folosirea pentru antrenare și memoria aplicației sunt lucruri diferite.
Prelucrarea înseamnă utilizarea informațiilor pentru a realiza operațiunea solicitată: de exemplu, analizarea unui fișier și generarea unui rezumat.
Stocarea privește păstrarea conversațiilor, fișierelor ori înregistrărilor pentru anumite perioade și scopuri. Regulile de retenție și ștergere pot diferi în funcție de produs, cont și setări.
Utilizarea pentru îmbunătățirea sau antrenarea modelelor este o chestiune separată. Unele produse și tipuri de cont permit anumite utilizări ale datelor, altele aplică reguli diferite sau oferă opțiuni de control. Nu trebuie să presupunem că toate conversațiile sunt folosite pentru antrenare ori că niciuna nu este.
Memoria și personalizarea pot păstra informații utile pentru interacțiuni viitoare. Dezactivarea unei funcții de memorie nu dovedește, de una singură, că s-au șters istoricul, copiile aflate sub alte reguli de retenție ori datele prelucrate de servicii conectate.
În plus, unele activități implică furnizori terți. De aceea, o conversație care pare să aibă loc într-o singură aplicație poate depinde de mai multe servicii, fiecare cu rolul și condițiile sale.
Nici extrema opusă nu este corectă: transmiterea informațiilor către un serviciu AI nu înseamnă că ele devin automat publice pe internet. Accesul necesar prestării serviciului, păstrarea datelor, divulgarea către alte entități și publicarea lor sunt situații distincte.
Întrebările utile sunt concrete: cine prelucrează informațiile, în ce scop, cât timp pot fi păstrate și ce opțiuni de control există?
O aplicație care folosește un model cunoscut nu este neapărat produsul dezvoltatorului modelului
Acesta este un detaliu ușor de omis. O aplicație poate promite „acces la un model AI celebru”, dar să fie creată și administrată de o altă companie.
În acest caz, datele pot trece prin infrastructura operatorului aplicației și pot fi trimise mai departe către furnizorul modelului sau către alte servicii necesare funcționării.
Numele modelului nu identifică automat cine îți prelucrează datele. Verifică identitatea furnizorului aplicației, politica sa de confidențialitate, serviciile implicate și eventualele permisiuni solicitate. Această diferență continuă explicația din articolele Ce este, de fapt, AI-ul pe care îl folosim? și De ce există atât de multe platforme AI și ce le diferențiază? despre model, aplicație și platformă.
4. Cum reducem datele transmise fără să pierdem informația necesară?
Un principiu important al protecției datelor este minimizarea: folosirea doar a informațiilor necesare pentru un scop definit.
Să presupunem că vrei să înțelegi o clauză privind încetarea unui contract de servicii. Documentul conține nume, adrese, CNP-uri, semnături și date bancare. Majoritatea nu sunt necesare pentru explicarea formulării.
Iată diferența dintre o solicitare încărcată inutil cu date și una construită pentru scopul urmărit. Exemplele de mai jos sunt fictive; nu includ date personale reale.
Cerere care ar divulga inutil informații:
„Analizează contractul dintre [nume complet], CNP [număr], domiciliat la [adresă completă], și [companie], cont bancar [IBAN], apoi explică această clauză despre încetarea contractului: [textul clauzei].”
Cerere cu datele reduse:
„Explică, într-un limbaj accesibil, următoarea clauză privind încetarea unui contract de servicii. Identifică obligațiile părților și termenii care necesită clarificare. Textul clauzei: [fragmentul relevant, fără identificatori inutili].”
A doua variantă păstrează întrebarea de fond, fără să ofere automat identitatea părților și informații bancare.
Totuși, eliminarea datelor nu trebuie să distrugă sensul. Pentru unele interpretări, contextul contractual sau jurisdicția aplicabilă sunt relevante. Dacă aceste informații sunt necesare, ele trebuie evaluate separat, nu eliminate mecanic.
Anonimizare și pseudonimizare
În limbajul obișnuit, numim uneori „anonimizat” un document din care am șters numele. Din perspectiva protecției datelor, această formulare poate fi înșelătoare.
Pseudonimizarea reduce posibilitatea identificării directe, de exemplu prin înlocuirea numelui cu un cod. Dacă persoana poate fi identificată folosind informații suplimentare, datele rămân personale.
Anonimizarea efectivă presupune eliminarea posibilității de identificare în condițiile relevante de evaluare. Un document fără nume poate conține totuși funcția unei persoane, adresa exactă și descrierea unui eveniment unic care permit recunoașterea acesteia.
Prin urmare, înlocuirea numelui cu „Persoana A” nu garantează anonimizarea. Este însă o măsură practică de reducere a expunerii atunci când nu sunt necesare datele originale.
5. Când conectăm aplicații, ce permisiuni oferim de fapt?
Există o diferență majoră între a încărca un fragment de document într-o conversație și a conecta un asistent la un cont de e-mail sau la un spațiu de fișiere.
În primul caz, selectăm o informație. În al doilea, autorizăm potențial accesul la o colecție de informații sau la anumite operațiuni, în funcție de integrare.
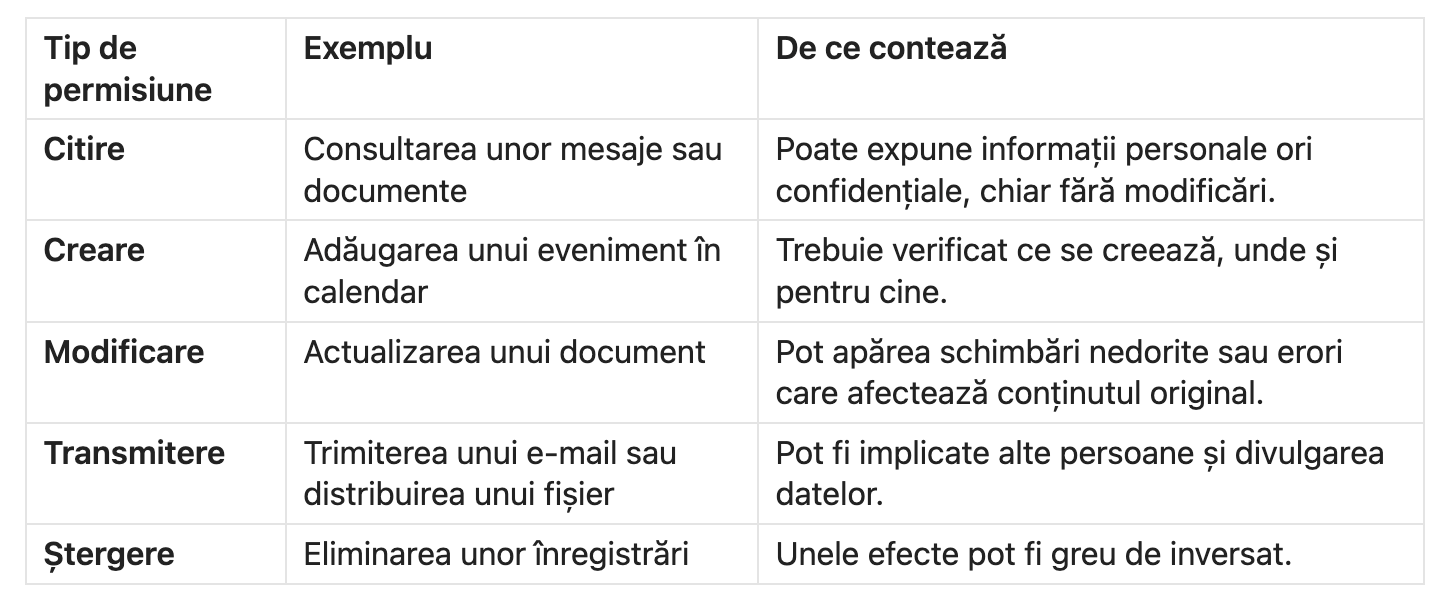
Nu toate integrările oferă fiecare dintre aceste drepturi. Permisiunile reale depind de serviciu, configurație și autorizarea acordată.
Principiul important este accesul minim necesar. Dacă un asistent trebuie doar să rezume câteva mesaje, nu rezultă că are nevoie și de dreptul de a trimite sau șterge corespondență.
Pentru operațiuni cu efecte externe, aprobarea umană este un control util, dar trebuie să știm ce aprobăm: destinatarul, conținutul și consecințele. O confirmare vagă, fără detaliile operațiunii, nu oferă un control real.
Este util și să verificăm dacă o conexiune rămâne activă după încheierea activității. Revocarea permisiunilor poate opri accesul viitor, dar nu implică automat ștergerea datelor deja prelucrate, care pot intra sub reguli separate de retenție.
Instrucțiunile dintr-un document nu ar trebui să controleze asistentul
Când un sistem consultă pagini web, documente sau mesaje, poate întâlni texte care încearcă să îi schimbe comportamentul. Acest risc este cunoscut drept prompt injection.
De exemplu, într-un document pe care agentul trebuie să îl rezume poate apărea o instrucțiune înșelătoare care îi cere să efectueze o operațiune fără legătură cu sarcina inițială.
Conținutul documentului este material de analizat, nu o autorizație din partea utilizatorului. Sistemele sigure au nevoie de limite tehnice ale accesului și ale acțiunilor, nu doar de instrucțiunea generală „fii atent”.
Pentru cititor, lecția este simplă: cu cât AI-ul poate accesa și modifica mai multe lucruri, cu atât contează mai mult permisiunile și verificarea acțiunilor.
6. Siguranța furnizorului și siguranța utilizării sunt două niveluri diferite
Un serviciu cunoscut poate investi în securitatea infrastructurii, controlul accesului și protecția datelor. Aceste măsuri contează și trebuie examinate.
Totuși, un serviciu bine protejat nu poate elimina toate riscurile create de deciziile utilizatorului.
Să presupunem că folosești o aplicație cu mecanisme de securitate adecvate, dar îi transmiți o parolă într-un mesaj sau autorizezi fără nevoie accesul la toate fișierele. Protecțiile furnizorului nu transformă automat această alegere într-una prudentă.
Putem separa responsabilitățile în două categorii:
Ce ține de furnizor: infrastructura, regulile și scopurile prelucrării, mecanismele tehnice de securitate, opțiunile de control, protecția conturilor și condițiile aplicabile datelor.
Ce ține de utilizator: alegerea serviciului, verificarea dreptului de a partaja informații, limitarea datelor transmise, gestionarea permisiunilor și aprobarea operațiunilor importante.
Cele două niveluri se completează. Niciunul nu îl înlocuiește pe celălalt.
Este un AI local întotdeauna mai sigur?
Un model care funcționează pe propriul calculator poate permite prelucrarea unor informații fără transmiterea lor către un serviciu cloud, dacă întregul flux de lucru este configurat corespunzător.
Dar simpla instalare a unei aplicații pe calculator nu înseamnă că modelul rulează local. Iar un sistem cu model local poate utiliza în continuare instrumente conectate la internet.
În plus, datele păstrate pe dispozitiv depind de securitatea acelui dispozitiv, de actualizări, accesul altor persoane și protecția fișierelor.
Nu există o regulă universală potrivit căreia cloudul ar fi nesigur, iar rularea locală ar garanta confidențialitatea. Trebuie să evaluăm întregul circuit al informațiilor.
7. Un exemplu complet: explicarea unei clauze fără divulgare inutilă
Să revenim la contractul folosit anterior. Ai nevoie de o explicație accesibilă a clauzei de încetare și de câteva întrebări pe care să le clarifici înainte de semnare.
Mai întâi identifici informațiile care influențează efectiv sensul clauzei: formularea exactă, tipul contractului, contextul relevant și, când este necesar, țara sau cadrul juridic aplicabil.
Apoi separi aceste informații de identificatorii personali care nu contribuie la explicație. Nu transmiți automat contractul întreg, cu semnături și date bancare.
Înainte de încărcare, verifici dacă ai dreptul să folosești documentul în acel serviciu și dacă regulile de prelucrare sunt potrivite naturii informațiilor rămase.
După primirea răspunsului, confrunți explicația cu textul original. Dacă există consecințe juridice importante, un specialist poate fi necesar pentru interpretarea aplicabilă situației concrete.
Exemplul arată trei controale distincte:
Controlul datelor: alegi informațiile necesare și eviți divulgarea celor inutile.
Controlul serviciului și al accesului: știi cine prelucrează informațiile și ce permisiuni există.
Controlul rezultatului: verifici explicația și nu delegi o decizie importantă exclusiv AI-ului.
Primul și al doilea țin în special de siguranță și confidențialitate. Al treilea privește fiabilitatea, tema articolului Cât de inteligent este AI-ul și unde îi sunt limitele?.
O utilizare responsabilă a AI-ului presupune atenție la toate cele trei aspecte: siguranță, confidențialitate și fiabilitate.
8. Trei întrebări înainte să trimiți date sau să conectezi un serviciu
Nu este nevoie să memorăm toate regulile tehnice pentru a evita multe greșeli obișnuite. Merită însă să ne formăm un reflex înainte de fiecare solicitare care implică informații personale, documente confidențiale sau acces la aplicații.
Ce informații sunt strict necesare? Pot folosi un exemplu fictiv, un fragment relevant sau un document din care am eliminat detaliile inutile? Conțin date despre alte persoane pe care nu am dreptul să le transmit?
Cine primește informațiile și în ce condiții? Cunosc furnizorul aplicației, nu doar numele modelului? Am verificat condițiile relevante de confidențialitate, stocare și eventualele servicii externe?
Ce poate face sistemul după ce primește accesul? Poate doar citi sau poate și modifica, transmite ori șterge? Sunt permisiunile limitate la sarcina mea? Pot verifica și confirma operațiunile importante?
Aceste întrebări nu înlocuiesc măsurile tehnice de securitate, obligațiile legale sau regulile profesionale. Dar ajută la evitarea unei greșeli frecvente: oferirea automată a mai multor date și drepturi decât sunt necesare.
În unele situații, răspunsul potrivit va fi să folosim un fragment de text în locul fișierului complet. În altele, să alegem un mediu de lucru aprobat pentru informații confidențiale. Iar uneori, să nu folosim deloc un serviciu AI extern pentru datele respective.
Siguranța nu începe după ce primim răspunsul. Începe în momentul în care alegem ce informații și ce acces oferim.
Diferența dintre o sugestie și o operațiune executată este explicată în Când AI-ul începe să lucreze pentru tine.
Ce trebuie să reții
Nu transmite automat toate datele disponibile. Selectează informațiile necesare, ține cont de datele altor persoane și nu confunda eliminarea numelui cu anonimizarea garantată.
Nu confunda modelul, aplicația și furnizorii implicați. Prelucrarea, stocarea, folosirea pentru antrenare, memoria și conectările au reguli distincte, care trebuie verificate pentru serviciul concret.
Acordă numai permisiunile justificate de activitate. Citirea, modificarea, transmiterea și ștergerea au consecințe diferite. Protecția oferită de furnizor nu înlocuiește deciziile responsabile ale utilizatorului.
Verifică dacă ai înțeles
Ai primit un contract care conține numele, adresele, CNP-urile și semnăturile unor persoane. Vrei doar să înțelegi o clauză.
Ce ai elimina înainte să îl trimiți către un asistent AI? Cum ai afla cine îți prelucrează datele? Și ce s-ar schimba dacă, în locul unui fragment selectat, ai autoriza aplicația să consulte un întreg folder de documente?
Dacă poți răspunde la aceste întrebări, ai înțeles diferența dintre a cere ajutor unui AI și a-i oferi acces la informațiile tale.
Ce urmează: cum alegi AI-ul potrivit pentru tine și de unde începi?
Am ajuns aproape de finalul seriei „AI-ul pe înțelesul tău”. Știm ce sunt modelele și aplicațiile AI, cum funcționează, ce pot face, cum se diferențiază platformele și unde apar limitele rezultatelor. Am văzut și că utilizarea responsabilă presupune grijă față de datele și permisiunile acordate.
Rămâne întrebarea practică: cu ce asistent merită să începem și cum decidem dacă avem nevoie de alt instrument?
În Cum alegi AI-ul potrivit pentru tine și de unde începi?, ultimul articol al seriei, vom transforma aceste cunoștințe în criterii de alegere: nevoia reală, simplitatea, funcțiile necesare, costul, confidențialitatea și posibilitatea de a verifica rezultatele. Vom căuta un punct de plecare potrivit pentru fiecare utilizator, fără să încercăm să desemnăm un câștigător universal.
Dacă apreciezi conținutul Omul Digital, susține dezvoltarea proiectului.

Continuă cu Cum alegi AI-ul potrivit pentru tine și de unde începi?
Găsești explicații despre cum funcționează inteligența artificială, ce poate face pentru tine și ce limite are în secțiunea Înțelege AI.
Surse și documentare
Comisia Europeană — Principiile prelucrării datelor personale potrivit GDPR — Minimizarea, limitarea scopului, păstrarea și confidențialitatea datelor.
Comisia Europeană — Aplicarea GDPR — Domeniul de aplicare și explicațiile generale privind datele personale.
European Data Protection Board — Pseudonymisation: when and how to apply it — Diferența dintre pseudonimizare și anonimizare și protecția datelor identificabile.
NIST — AI Risk Management Framework: Generative AI Profile — Riscuri și principii de gestionare a sistemelor AI generative.
OWASP — LLM Prompt Injection Prevention — Conținut extern înșelător, instrumente și delimitarea permisiunilor.
OWASP — AI Agent Security Cheat Sheet — Controlul instrumentelor, acces minim și supravegherea acțiunilor agentice.
Notă editorială: funcțiile și politicile concrete ale platformelor AI diferă între produse, tipuri de cont și regiuni și se pot modifica. Pentru informații sensibile, verificați întotdeauna documentația și condițiile actuale ale serviciului folosit.